
机器人型号库实操:外观相似的名称怎样保留差异
2026-11-04
机器人型号库实操:外观相似的名称怎样保留差异
机器人型号库整理多来源资料时,最棘手的问题之一是两条名称看起来几乎一样。把它们立即合并可能丢失原始区别,完全当成无关条目又可能让目录难以检索。阅读者可以先分清三个问题:文件怎样写出字符串、字符有哪些表示形式、业务上是否指向同一型号。它们相关,却需要不同的依据。
先分开传输写法与实际字符串
RFC 8259的字符串比较部分提醒,比较时若没有转换转义字符,可能错误判断字符串是否相等。这说明文件中肉眼可见的写法,并不总是解读后的字符内容。型号资料审阅时,可以同时保留来源片段和解析后的值,让两者承担不同角色。
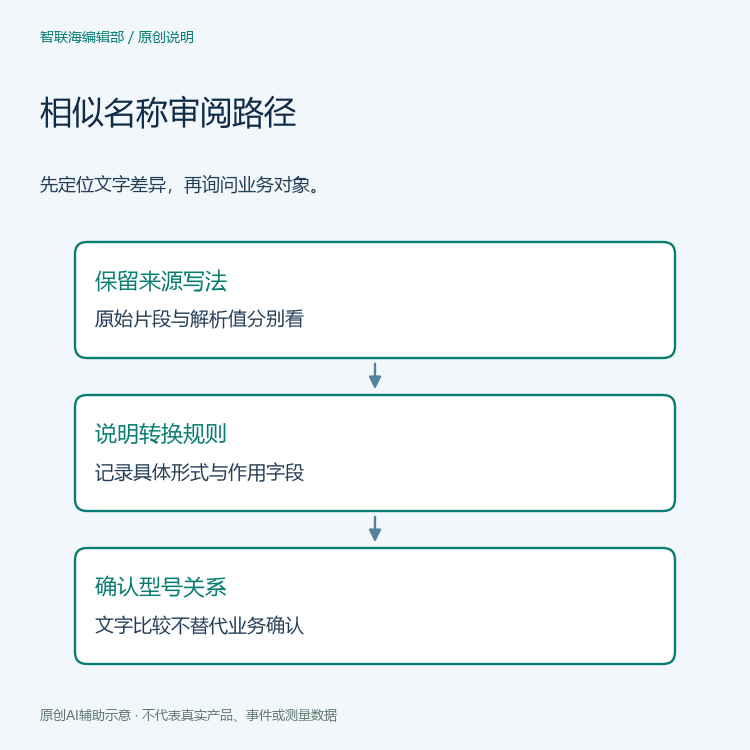
来源片段用于说明“收到的文件是什么样”,解析值用于说明“接收工具把它理解成什么”。如果同事提出名称不一致,先问他比较的是哪一层。一个人在看原始附件,另一个人在看页面展示,双方可能并没有在比较同一种对象。这一步只定位差异所在,不急着给来源贴上错误标签。
正规化是有名字的转换规则
Python的unicodedata文档列出了NFC、NFD、NFKC、NFKD等正规化形式,并区分规范等价与兼容等价所依据的处理。引用这些名称时,应当保留具体形式,不能把所有转换概括为“统一字符”。本文使用当前Python文档解释概念,不表示型号库已经运行某种转换。
对编辑工作而言,关键是追问规则为何适用于本字段。搜索入口可以有便于查找的处理,而制造商原始名称仍应能够回溯。若某个交付说明只写“做过标准化”,可以要求提供转换规则名称、作用字段和原值保留方式。规则写得清楚,并不自动回答两台产品是否相同。
虚构名称例子先留下两个位置
假设一份虚构目录收到“系列甲”的两条资料。页面字体让某个带附加符号的字母看起来相同,但接收记录显示两份字符串的组成有差异。编辑此时可以为两条来源各保留一个位置,标注“文字形式待核对”,并将疑问指向具体名称字段,而不是把整条产品资料宣布为重复。
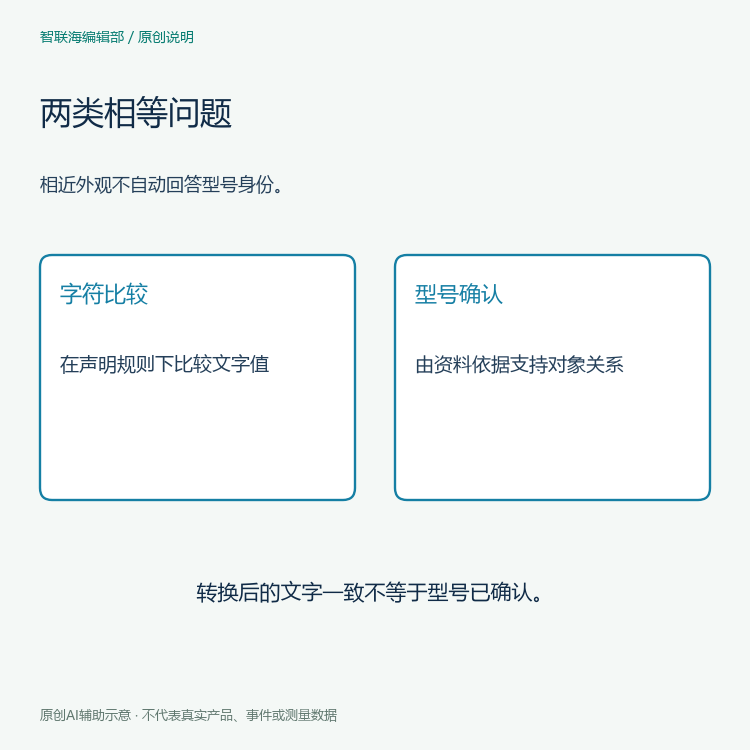
接下来的询问应分两部分。资料团队说明字符处理经过,产品资料负责人确认两个条目是否属于同一型号或修订。即使某一种正规化形式使比较结果一致,也只能支持那项转换下的文字比较,不能代替制造商对型号身份的确认。本例没有真实型号,也没有执行转换,更没有展示一项已完成的去重结果。
显示名称与检索辅助值各有用途
一种可供讨论的目录设计,是保留来源名称作为显示依据,另为检索辅助值说明生成规则。这样,读者查找时用到的宽松条件不会悄悄改写来源事实。是否采用这种设计,需要结合实际目录与使用需求决定;本文并不提出适用于所有系统的唯一字段结构。
当后续收到供应商更正,应把更正对象说清楚:它修改的是名称拼写、别名关系,还是型号归属。不同修改会影响不同部分的阅读结论。本站资料栏目提供继续整理阅读问题的入口,相关信息栏目也可作为导航;读者不应把栏目名称理解为已有某条型号记录的保证。
用可解释的差异记录结束本轮审阅
本轮审阅可以交付一段有限说明:“两份来源的名称显示相近,字符组成需进一步核对;业务同一性未确认,原值分别保留。”这样的记录没有给出武断去重结论,却能明确下一位同事应向谁询问什么问题。若后来取得确认,再把依据附在对应位置,避免只留下一个失去来历的合并结果。
复查时仍要回到原始值和已声明的规则。如果规则改变,过去得到的文字比较结论也需要重新评估;如果只补充了业务说明,则应更新业务关系,而不是假装字符差异已经消失。把这两条线写清楚,有助于让型号库既便于阅读,又能保留来源的具体样貌。


